作品 / AI工具链
脱敏网关
合同这类文本发给外部模型之前,先在本机把公司名、人名、电话换成占位符;对照表留在本机,要用时再换回来。开源,MIT。
这是什么,适合谁
一个在本机运行的敏感信息处理层,源码公开(MIT)。它做的事情很具体:调用外部大模型之前,先在本机识别文本里的敏感信息,用占位符替换需要保护的原值,把对应关系留在本地;需要恢复时,再通过受控的本地流程回填。
适合每天要拿真实业务材料问模型、又不想让企业数据直接出网的人。合同审查、知识库、智能体这些工作都会接触内部材料——这个项目把「先处理再出门」做成可以重复调用的能力,而不是每次手工删一遍。
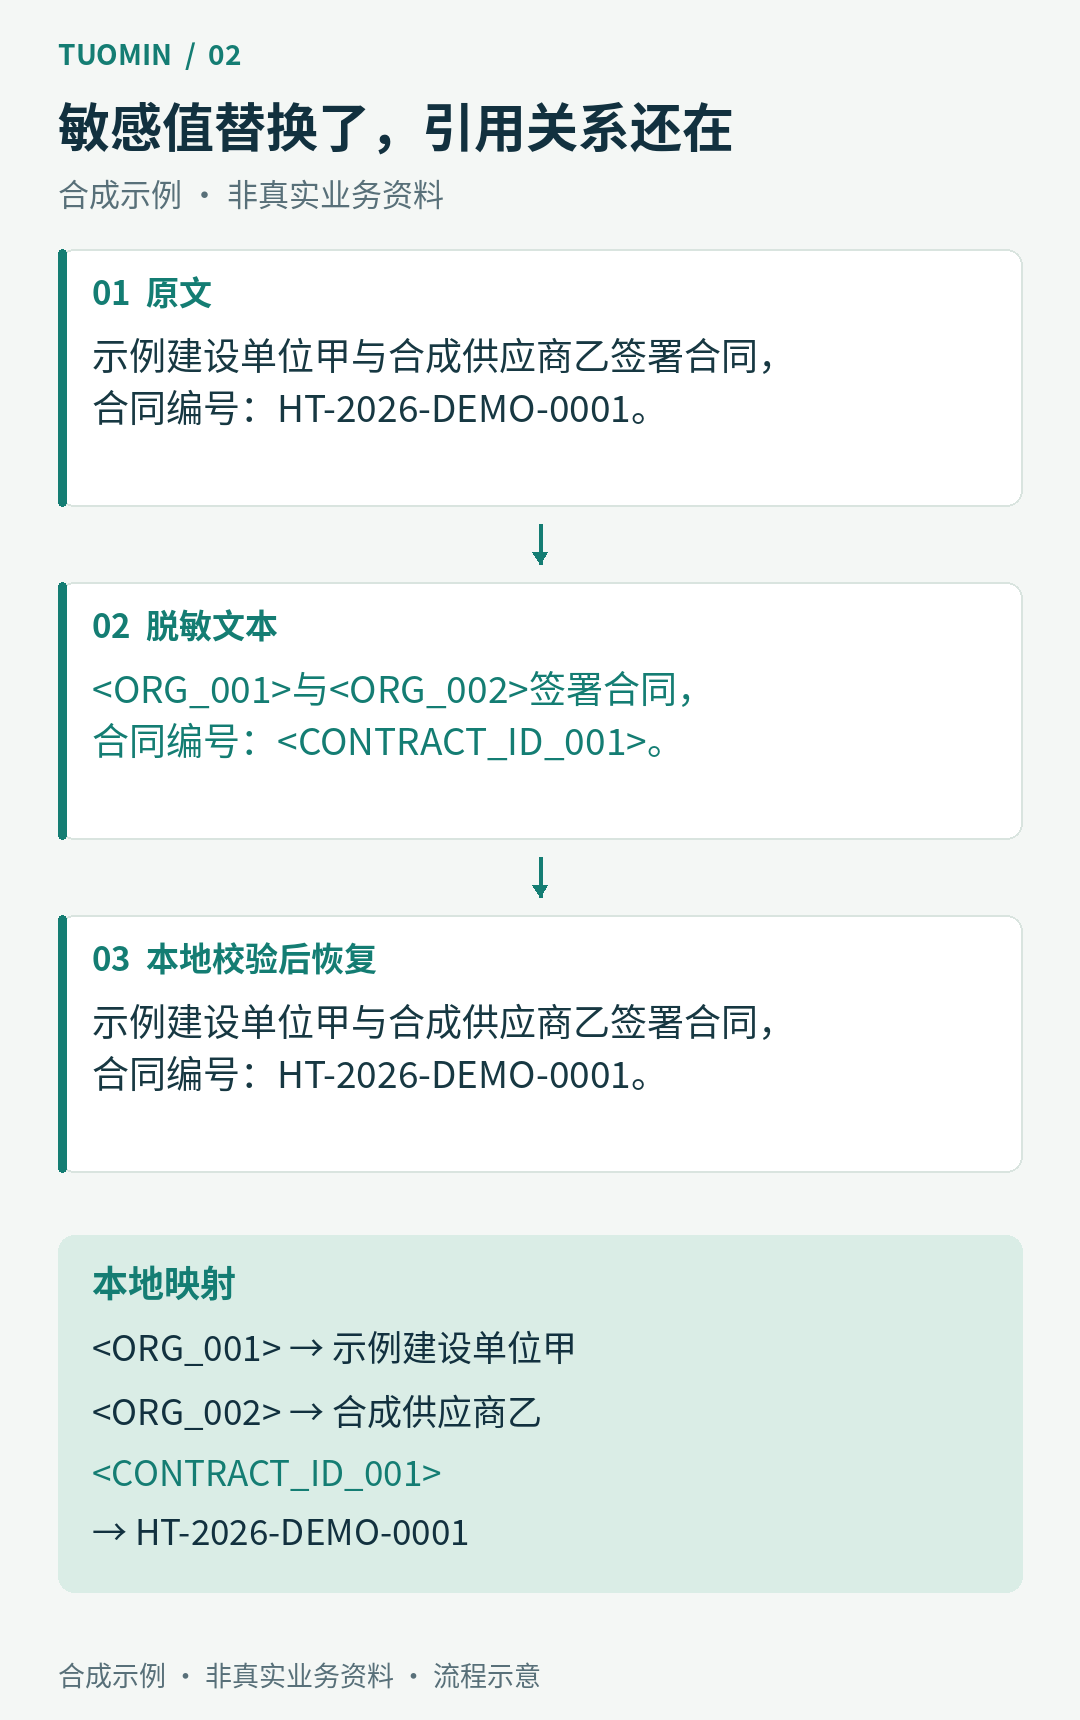
用一段合成合同看最直观。下面的单位名称和编号都只用于演示:
示例建设单位甲与合成供应商乙签署合同,合同编号:HT-2026-DEMO-0001。
声明相应词典并识别合同编号后,得到的是:
<ORG_001>与<ORG_002>签署合同,合同编号:<CONTRACT_ID_001>。
模型仍然知道这里有两个不同的主体和一份合同;后续内容再次提到同一主体时,相应作用域内继续使用同一占位符,引用关系保留下来。
实际如何使用
最小示例不依赖任何外部模型,不联网,不需要 API Key。Python 3.10 以上:
git clone https://github.com/Doubixilin/tuomin-open-source.git
cd tuomin-open-source
python -m venv .venv && source .venv/bin/activate
python -m pip install .
python examples/minimal_demo.py
成功时输出「示例验证通过」。它验证的是流程和占位符完整性,不代表真实材料的敏感信息都被识别——规则和词典只能识别覆盖到的格式与已声明的实体。
再往上是本地服务:安装 .[serve,document] 后 tuomin-gateway serve,打开 /ui/ 控制台。接入外部应用时,把兼容客户端的 Base URL 指到网关,例如 OpenAI 风格的地址 http://127.0.0.1:8765/apps/gateway_demo/v1。我已经在 OpenClaw 和 WorkBuddy 里实际跑通过接入。
为什么做
出发点是一次比赛演讲里的一段话:使用云端算力的数据安全是共同的担忧,没有安全的底座,合同审查、知识库、智能体都是镜花水月。
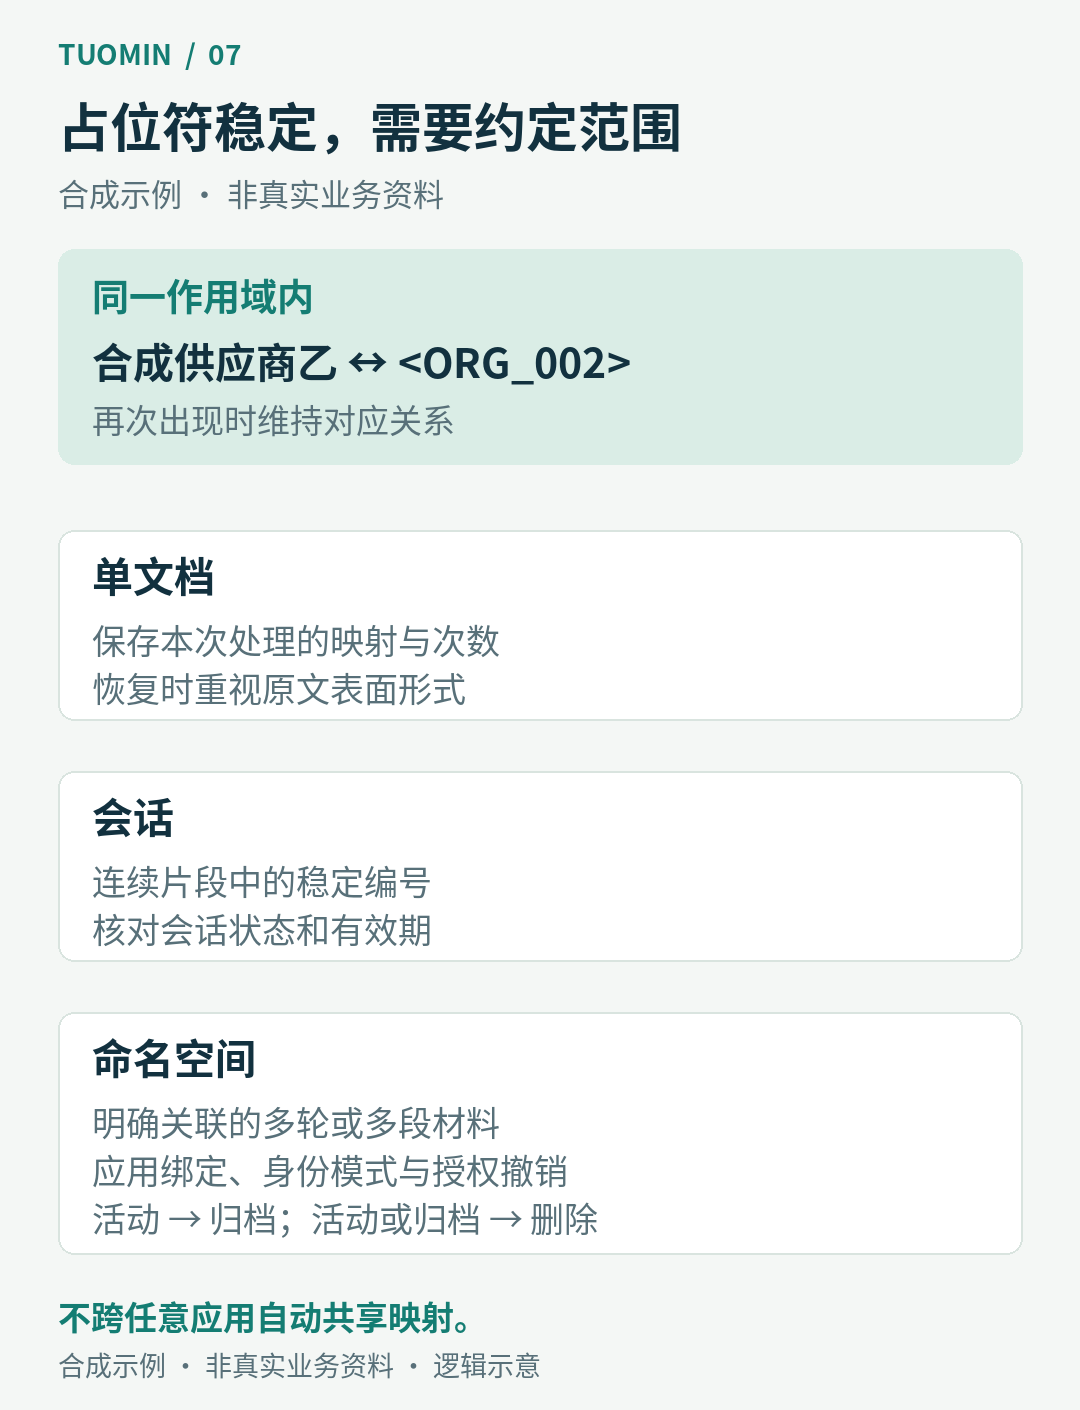
设计上最在意的是「最小影响」:敏感值隐藏之后,文本还要有用。名称可以暂时隐藏,谁与谁发生关系、前后是否指向同一主体,这些信息要留下来。如果后面的条款写着「合成供应商乙应在验收后提交结算资料」,处理之后应当仍能辨认这是 <ORG_002> 的义务。这决定了它走可逆占位符的路线,而不是一删了之。
架构:一条链路,五个层面
代码按逻辑分层组织,但明确不是微服务图——模型代理在服务进程内直接调用检测引擎,不为每次脱敏增加一次本地 HTTP 跳转;CLI 最小示例直接调核心函数,不过 HTTP。
链路自上而下:接入层(Web 控制台、HTTP API、模型代理、CLI、本地 MCP)→ 入口编排(文本、文档、批量、会话、命名空间五种)→ 应用注册与策略(registry / profiles / policy)→ 检测与变换引擎(detectors / fusion / session / redactor)→ 映射与存储(mapping / vault / namespace_vault / platform_security)→ 回填(refill / document/refill_flow),旁路还有 guard / audit / jobs / inspection。
想读代码的话,文档给了推荐顺序:detectors/rules.py → detectors/dictionary.py → fusion.py + spans.py → redactor.py + mapping.py → refill.py。
检测流水线:三种来源如何融合成一段「跨度」
核心数据是跨度:这段内容在原文哪里开始、哪里结束、属于什么类别、来自哪个检测器。保留原文位置,后续才能精确替换,也能核查判断依据。
三个来源分工:规则管格式明确的信息(编号、证件、有特征的凭据字符串),行为容易解释、方便补测试;词典管明确声明的业务实体,条目可以带标签、风险级别和版本,业务知识直接进入检测;本地 NER 补充开放文本里的人名、组织和地址候选——面向中文 CLUENER 微调模型,标签映射 company/organization/government → ORG、name → PERSON、address → ADDRESS,它不是通用的多语言敏感内容分类器。
融合层不是简单投票:NER 候选优先级低于精确词典和规则,冲突处理还涉及置信度、长度和边界修正。长文本切成 384 字符窗口、64 字符重叠、每批最多 8 个窗口,切分尽量照顾换行和句界——文档里明确标注这些是实现参数,不是准确率承诺。
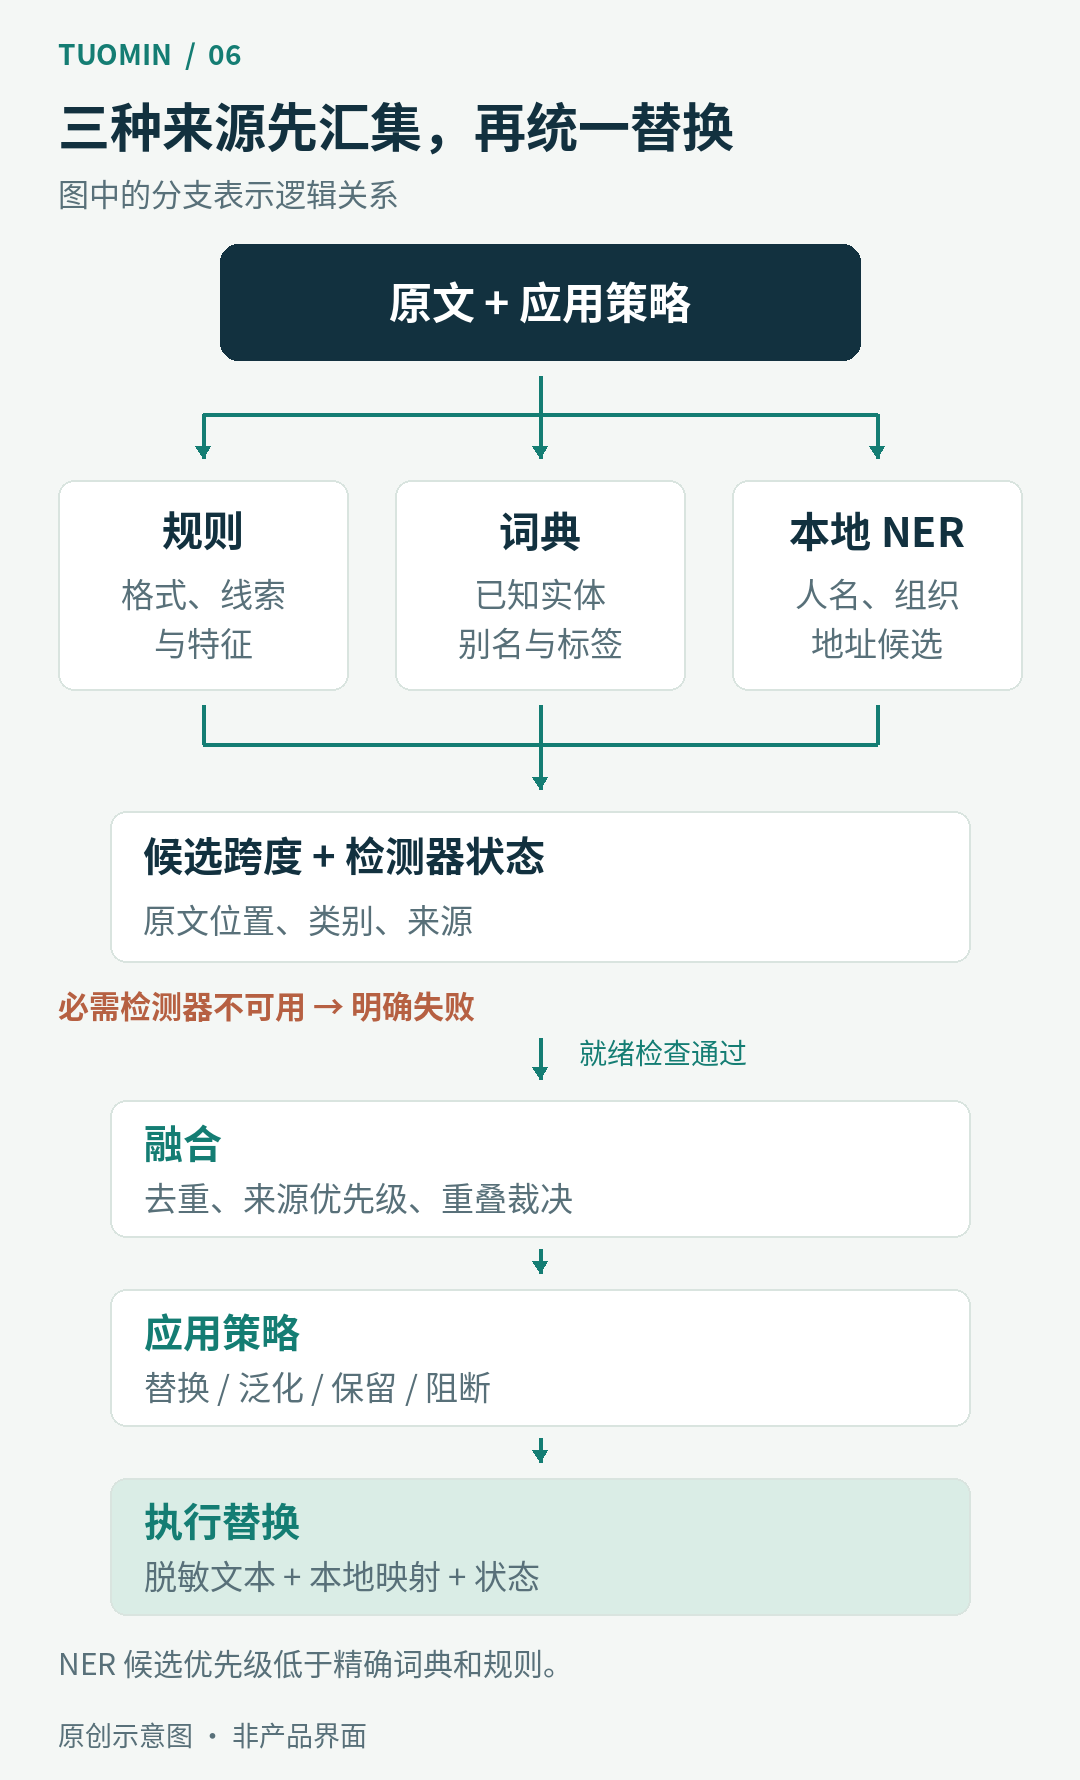
检测结果再过应用策略:可逆替换、可选泛化、允许保留、阻断,四种动作。成功泛化的值不作为可逆占位符写入普通恢复映射——需要逐字恢复的流程,要选可逆策略。
占位符、映射与作用域
单次处理和会话处理是两条路径。会话路径会补检已经拥有的实体值、维持稳定编号,在锁内更新映射与编号、检测运行在锁外——并发边界在文档里是画出来的,不是笼统宣称线程安全。
redact 返回的是与应用绑定的不透明句柄,不是整张原值表。Vault 保存原值映射和预期占位符次数。保留脱敏输出但丢了对应映射,并不能从占位符本身推导回原值。
命名空间是一台小状态机:活动 → 已归档 → 已删除。归档停止继续写入,但不自动撤销已有映射授权;删除会先撤销关联的映射句柄。已经导出的恢复包和已经交付的原值,不会因此自动消失。
回填:按恢复对象分合同
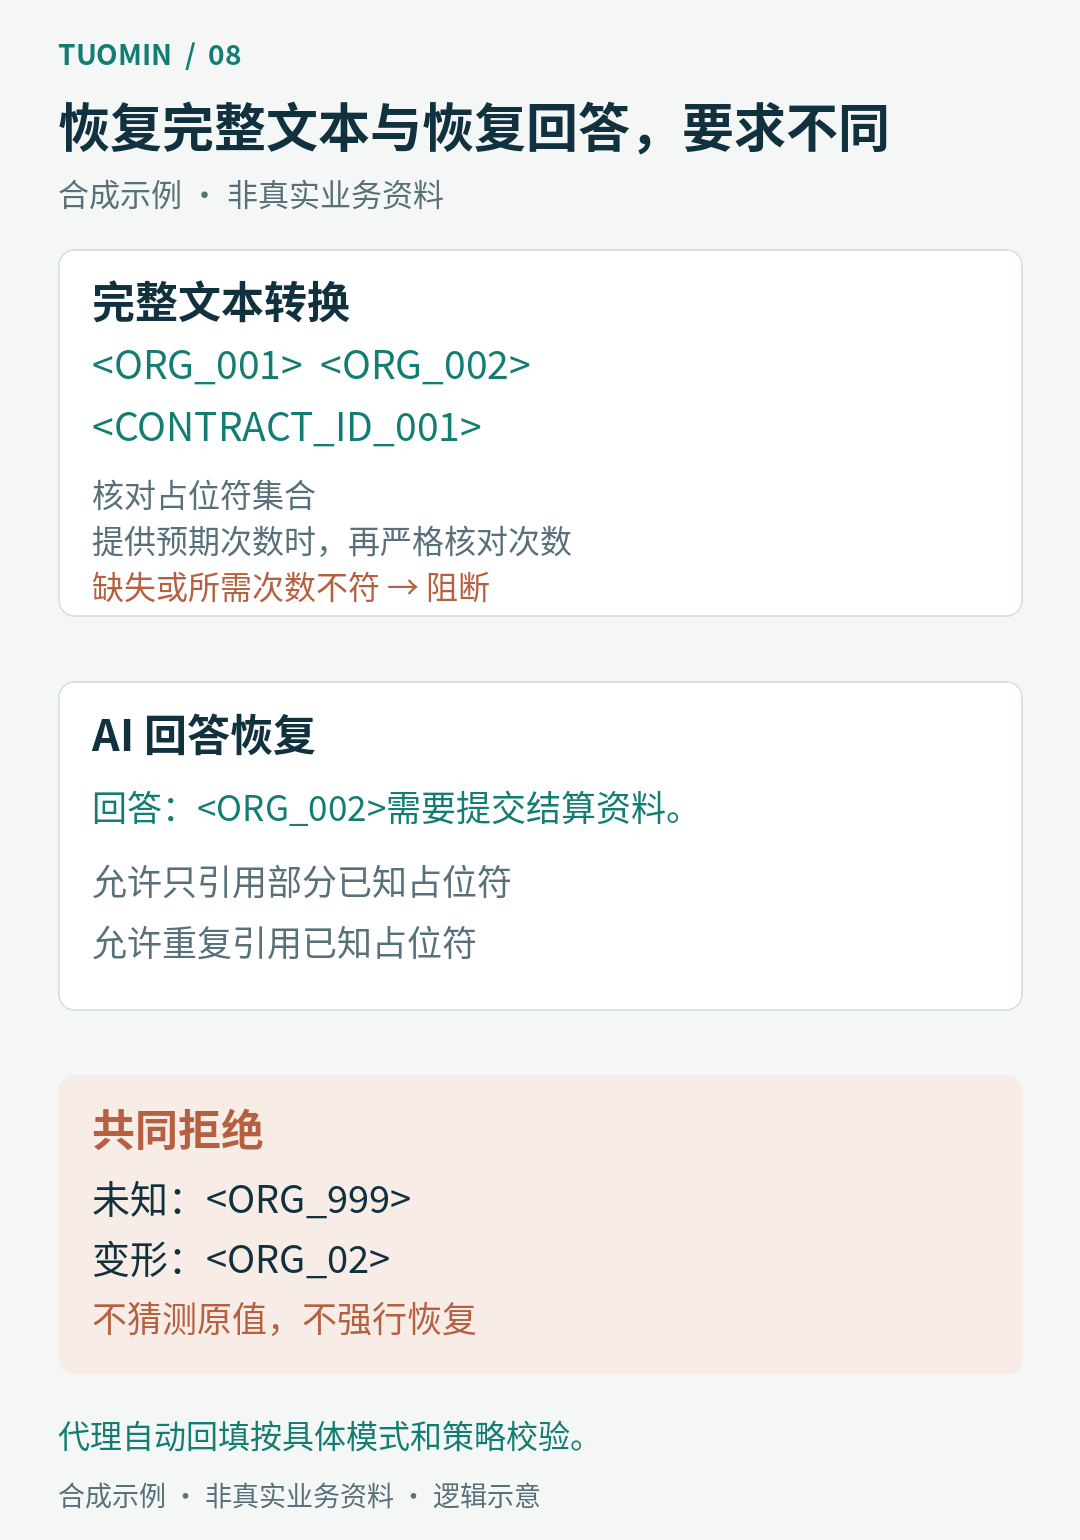
「把占位符换回原值」看起来简单,但不同结果对完整性的要求差别很大,所以回填合同是按场景分的:
| 恢复对象 | 缺少原有占位符 | 重复引用 | 未知或变形占位符 |
|---|---|---|---|
| 完整文本转换 | 阻断;提供了预期次数就按次数严格检查 | 同左 | 阻断 |
| 可信预览 | 允许引用子集 | 允许 | 阻断 |
| 已编辑的 Markdown | 有差异先展示、由调用方确认 | 同左 | 阻断,确认不能覆盖 |
| AI 回答 | 正常情况 | 正常情况 | 阻断;零命中另要求确认 |
普通问答往往只提及少量实体,「没有重复所有输入占位符」并不天然是模型错误——选错合同会造成合法回答被拒绝。底线则相同:未知占位符不能凭空猜一个对应值,零命中不允许被误当成恢复成功。
网关接入:两种响应模式
代理覆盖 OpenAI 风格 /chat/completions 与 Anthropic 风格 /messages,JSON 与 SSE 都支持,两种协议分别转发、不相互转换。
默认模式保留占位符,响应带占位符返回客户端,适合核查脱敏效果。自动回填要走 /auto/v1 地址,并且应用必须显式 allow_auto_refill: true——只改客户端地址是打不开的,未获允许返回 403。严格模式下校验失败就返回错误,不交付未验证的恢复结果;因为回答省略占位符也可能被阻断,它适合完整文本转换,不能直接当成任意多轮聊天的通用配置。
权限也是分层的:检测/脱敏/回填要应用能力加独立的能力 Token(拿到脱敏能力不等于拿到可信回填);文档工作台要管理 Token;/admin/* 还要本机 Host 检查;管理 Token、能力 Token、上游 API Key 三类凭据不共用。app_id 只是路由,不构成客户端身份认证——这条接入依赖本机信任边界,不应直接开放成公网网关。
安全边界与进度
首次公开版的验证记录:macOS arm64 + Python 3.12.10 环境下 637 项通过、2 项跳过;PDF 依赖环境另有 36 项专项通过。最小示例的测试会主动拒绝模型模块导入、DNS 和网络连接,证明无模型路径不偷偷联网。回归里模型就绪用的是模拟检测器——不代表真实模型已加载。
- 不提供 OCR:图片和扫描 PDF 的文字读不到,「读取到的文字已处理」不等于「整个文件已脱敏」。
- egress_allowed 只表示当前配置与扫描通过,不是零漏检承诺。
- 代理只覆盖实际经过网关的请求;连接器、插件、直连流量不受保护。
- 存储加密分平台:macOS 钥匙串 + AES-GCM,Windows 用 DPAPI,Linux 当前有明文开发存储路径。
- NER 权重不随仓库提供,需自行核实许可;真实材料的覆盖率要用自己的业务验收。
检测和回填是两件事,分开验证:回填校验通过,并不能证明检测没有漏检。这个项目想提供的是一条可以看懂、可以运行、可以继续改进的链路——敏感值如何被识别、哪些内容会离开本机、谁能恢复原值,都有明确的位置可以检查。